
项目
已发表2025共同第一作者
JAMA+ AI 编辑精选2025 年度 JAMA Ophthalmology 人工智能领域最佳文章荧光素眼底血管造影视频生成与医疗数据共享
从临床文本生成动态眼底血管造影视频,探索隐私保护型医疗数据共享。模型融合 Wavelet-Flow VAE 与 Diffusion Transformer,成果发表于 JAMA Ophthalmology(2025)。
Generative AIMedical Video GenerationComputer VisionDiffusion TransformerWavelet-Flow VAEPythonPyTorch
概览
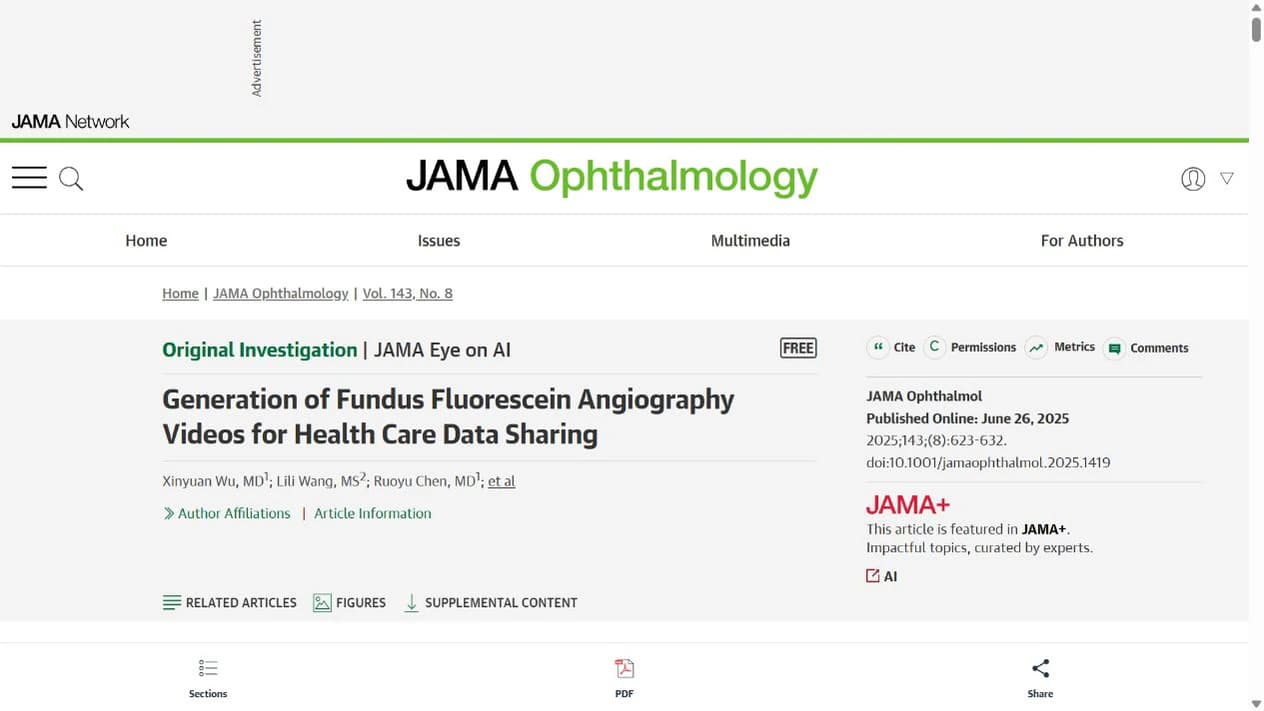
研发文本生成视频模型,根据临床文本描述生成动态荧光素眼底血管造影(FFA)视频,支持隐私保护型医疗数据共享。成果发表于 JAMA Ophthalmology(2025; 143(8): 623–632)。
问题
真实患者影像的共享受到隐私约束,影响研究、教学与模型开发。本项目探索根据临床描述生成动态影像,为医疗数据共享提供另一种技术路径。
我的角色
共同第一作者,以学术姓名 Lili Wang 署名。基于 Python 与 PyTorch 参与模型研发,包括 Wavelet-Flow VAE 与 Diffusion Transformer 的融合,以及眼底病变特征的时空建模。
已记录的作者贡献还包括研究构思与设计、数据获取与分析解释、论文撰写及统计分析。
方法
工作流程包含三个环节:
- 输入:FFA 检查的临床文字描述
- 模型:融合 Wavelet-Flow VAE 与 Diffusion Transformer
- 输出:生成的动态 FFA 视频
研究采用 3,625 段匿名 FFA 视频完成训练与评估。评价涵盖客观质量指标、文本—视频语义一致性、眼科医生主观评价及图像检索指标,用于考察生成质量与隐私保护能力。
结果
研究经同行评议发表于 JAMA Ophthalmology(2025),探索面向临床可视化、医学教育及隐私保护型数据共享的技术方法。具体实验设置与详细结果见论文。